Oracle数据库算子清单,看看你的数据库都做了多少?
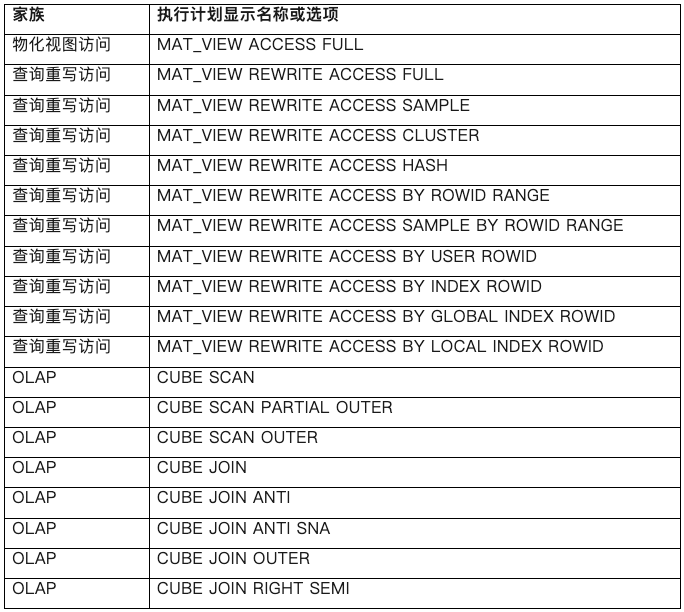
昨天我谈了我的观点,创新虽然重要,但是对于国产数据库而言,更重要的不是创新,而是认认真真把执行算子补全,让基础的SQL执行变得更加高效,各种SQL都能用最合适的算子跑出来,写得比较烂的SQL也能像Oracle那样跑得飞快。Oracle数据库能跑得快的原因就是我今天给大家列的算子清单。下面的清单有200多条,不过还没有穷举所有的Oracle执行算子。
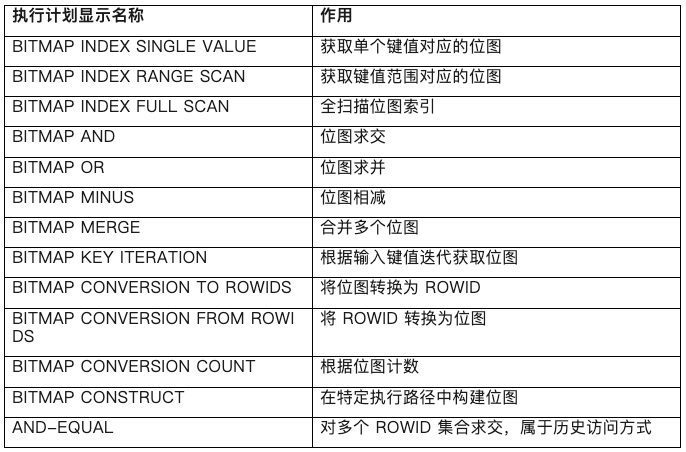
丰富的执行算子也说明了这款数据库是经过大量的应用场景打磨的,解决性能问题的最好的方法是数据库底层的算子对其有最优化的执行方案。有了最合适的执行算子,优化器才会变得更加强大。下面的十几张表格是Oracle 数据库执行算子,大家可以和国产数据库做个比较。
从下面的表格也可以看出,国产数据库在创新之余,还是有很多基础课程需要补课的,哪个数据库先把这些课补好,哪些数据库就能在性能和使用体验上超人一等。
一、表、索引与其他数据访问算子
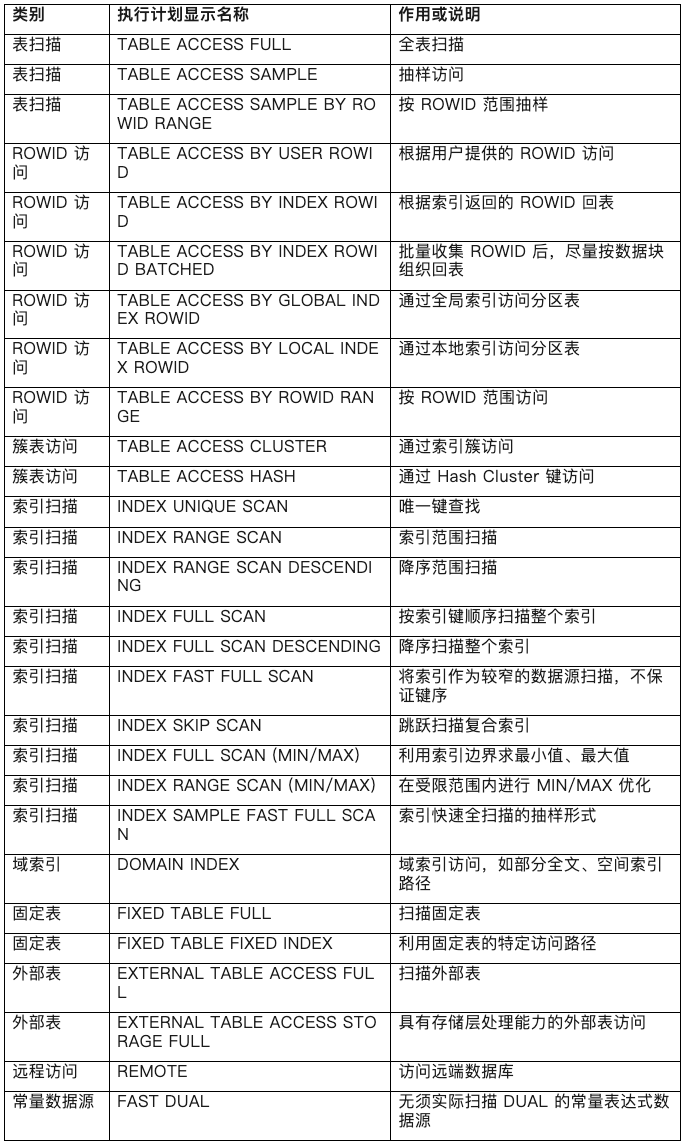
Oracle 官方通用表列出了主要表访问与索引扫描形式;其中 BATCHED 的含义是改善按块访问的聚集程度,12.2、18c 等文档已有明确计划示例。上述补充名称中,MIN/MAX、固定表、外部表等应继续以目标版本实测补齐版本属性。需要特别区分:
·TABLE ACCESS HASH 是 Hash Cluster 访问。
·INDEX FAST FULL SCAN 与 INDEX FULL SCAN 的有序性不同。
·DOMAIN INDEX 是扩展接口,不能仅凭这个名称判断内部使用哪一种算法。
三、连接算子
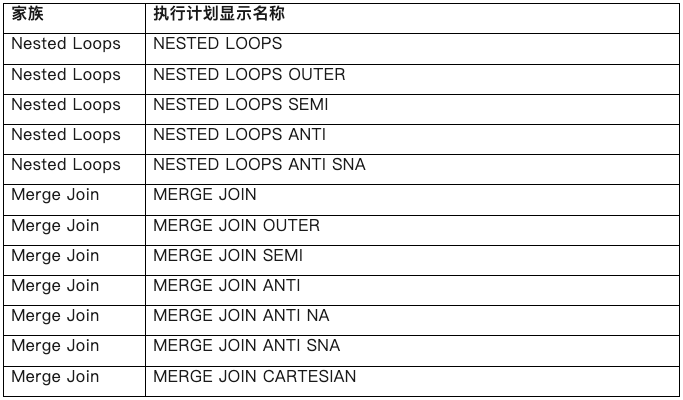
HASH JOIN 的全部主要变体在后面十四章单列,因为这也是目前国产数据库与Oracle相比,算子缺口最大的地方。这里先列其他连接家族。
四、排序、聚合、去重和窗口算子
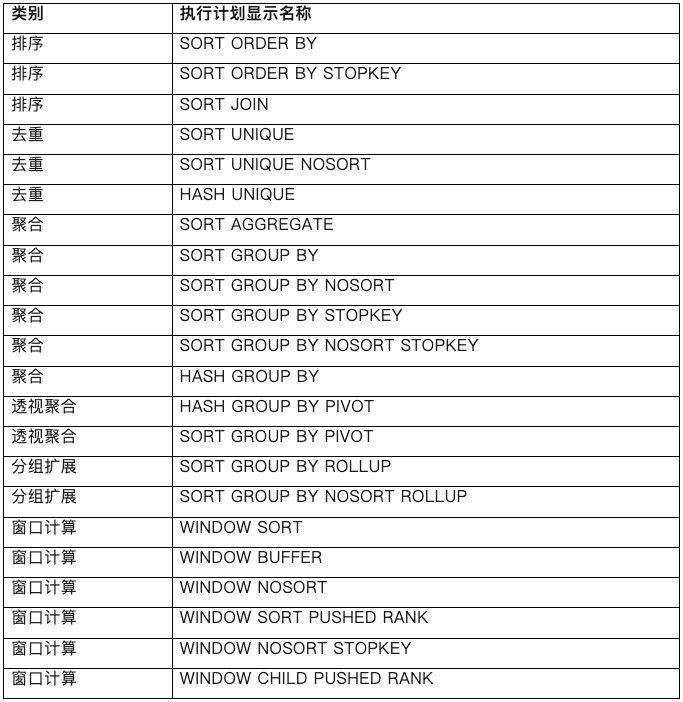
五、过滤、集合、视图和中间结果管理
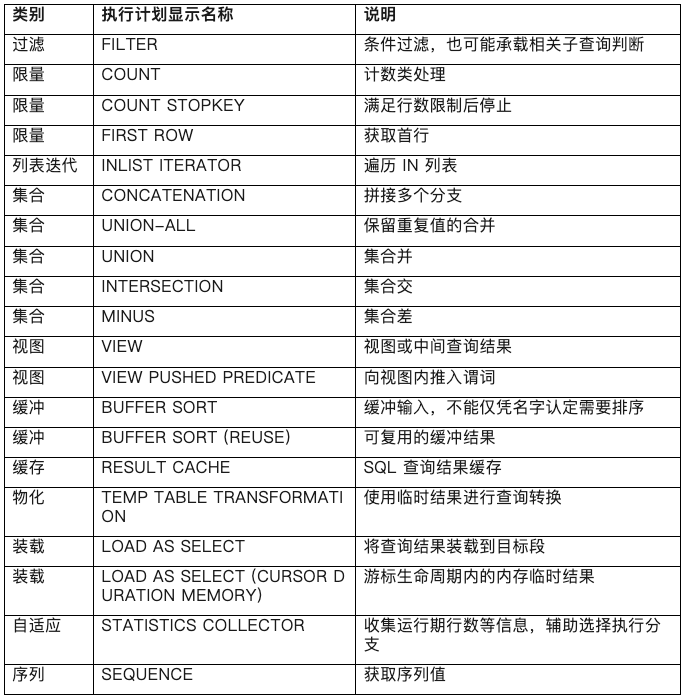
六、分区访问算子
下表用“前缀+选项”列举,不表示每一种前缀都支持所有选项。
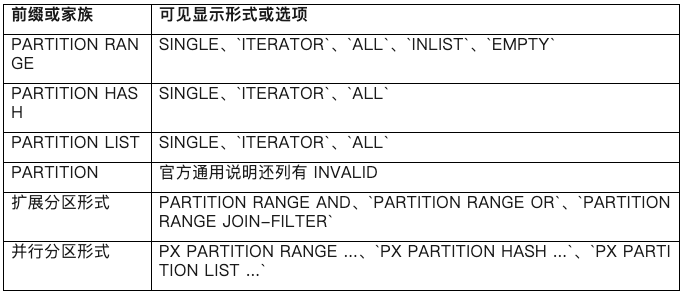
七、并行执行与数据分发算子
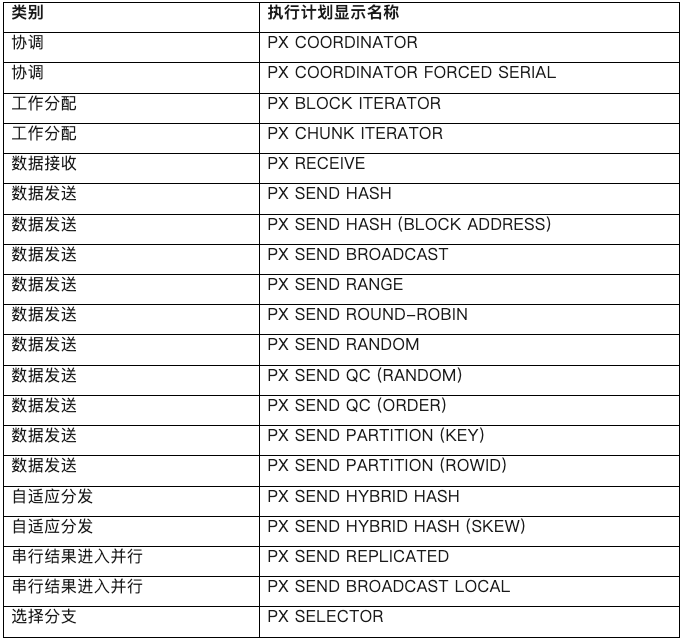
八、连接过滤与向量聚合算子
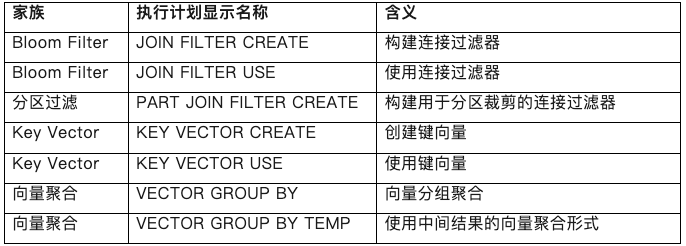
九、层次查询与递归查询算子
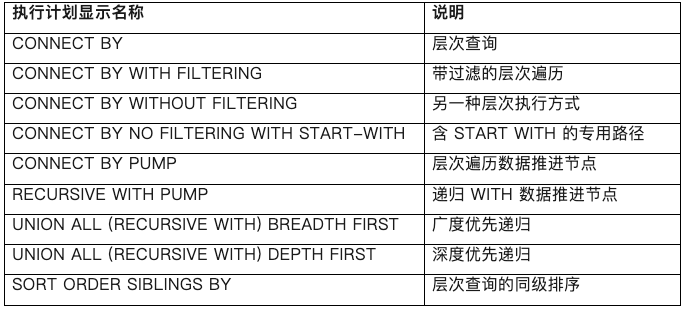
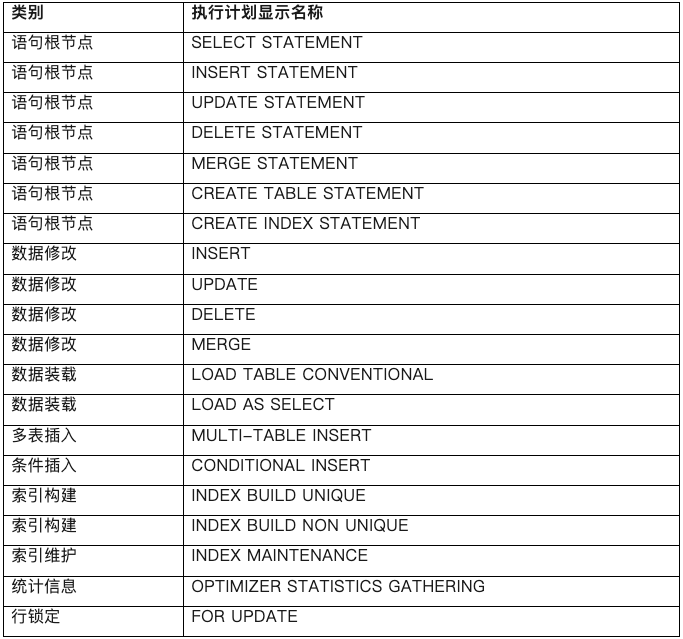
十、DML、DDL 与锁定相关节点
这些节点经常也被纳入广义“执行算子”,应与关系查询算子分开分类。
十一、集合、表函数、XML、JSON、MODEL 与模式匹配
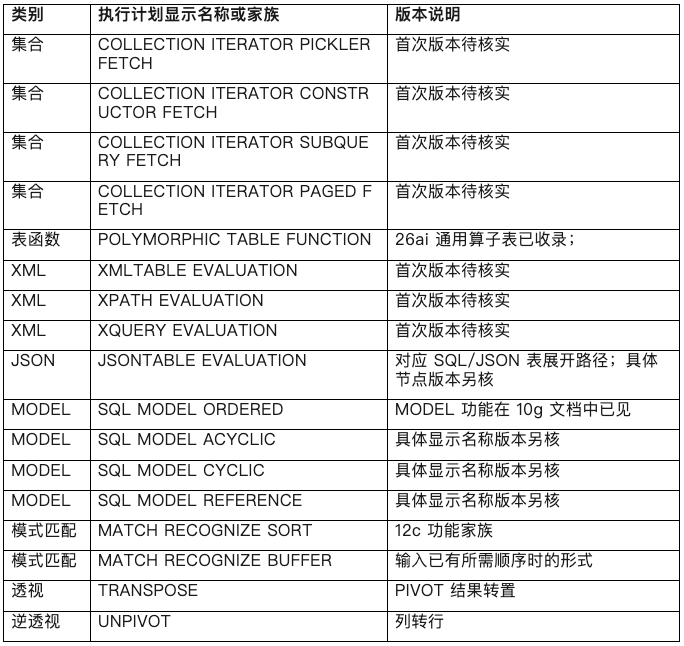
十二、物化视图与 OLAP
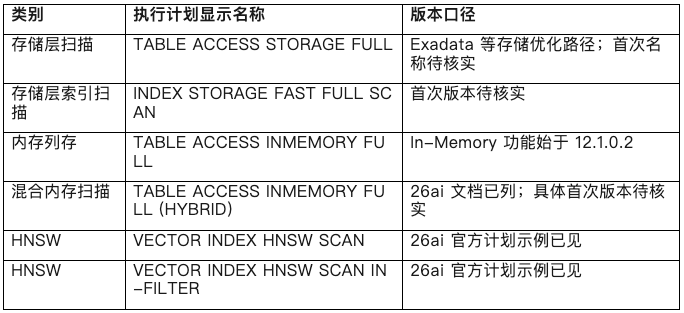
十三、Exadata、In-Memory 与 AI 向量检索
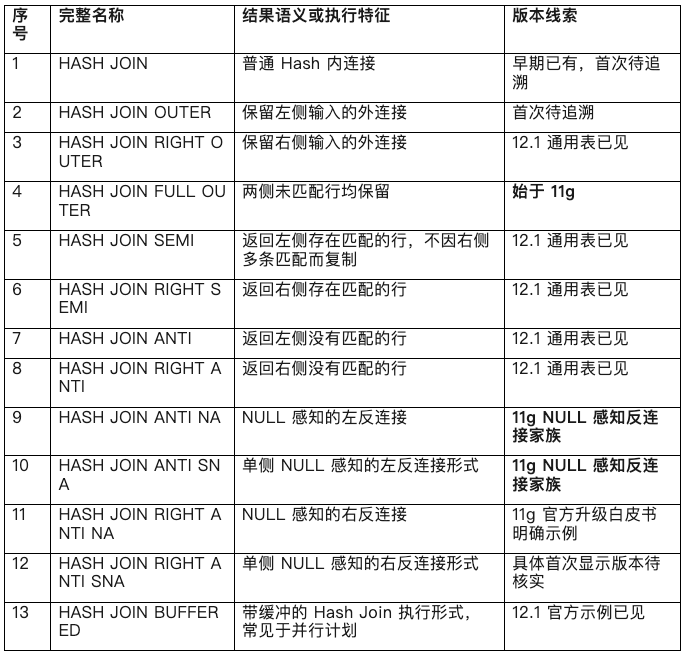
十四、HASH JOIN 相关的算子有哪些