
专访阿里云数据库陈宗志:Agent-Native是这个时代的“必修课”
“AI原生的数据底座,不是把AI装进数据库,而是让数据库自己长出Agent的能力。”阿里云数据库产品事业部RDS研发总负责人陈宗志(花名:暴跳)在DTCC大会采访时表示。
作为阿里云数据库AI方向战略落地的核心操盘手之一,陈宗志正带领团队向Agent时代转型,包括向量检索在内的诸多核心能力已在AliSQL社区上开源。他的思考,或许能帮助外界更清楚地理解:“Agent-Native数据库”究竟意味着什么,以及它将如何改变数据库的演进方向。
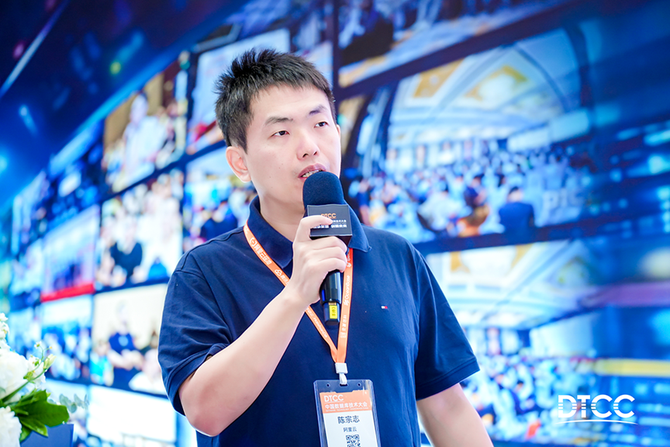
▲阿里云数据库产品事业部RDS研发总负责人 陈宗志(花名:暴跳)
当Agent开始接管数据库两端
“模型决定AI有多聪明,数据库决定AI能跑多远。”这是陈宗志这次的演讲主题,也是他对当前技术趋势的精准概括。
如何理解?从AI和数据库的发展路线来看,可以分为两个阶段:
第一阶段,模型的上半场,数据库是托底的“后勤”角色。人们关心的是“大脑”够不够聪明,主要盯着参数、盯着推理效果,数据库主要服务于训练数据的清洗与整理。在应用表现形式上,多以对话形式呈现,数据库通过增加向量能力来弥补大模型的不足。
第二阶段,模型的下半场,Agent大量涌现,人们发现数据库才是决定AI能走多远的关键变量。模型决定AI单次任务能做多好、反应多聪明,数据库决定AI能不能把无数次任务的经验沉淀下来。没有数据库的Agent,每一次启动都是从零开始的新手;有了之前经验的持续沉淀,Agent才能基于过往执行的历史、中间结果和决策痕迹完成更复杂的任务。
二者根本变化是,数据库的用户正在发生一次根本性的替换,生产端和消费端都被Agent接管。
Agent的访问逻辑完全打破了传统规则,人写代码时,系统会默认用户清楚表结构,数据库里有DDL 、DML,访问比例可能是10000:1。大部分人直接对表的某一个字段去访问,一般不会在查某一个表之前去看表结构信息。
对比之下,Agent是探索式的,先查表结构再找数据,DDL信息的访问变成对实际数据的信息访问一样。它天然试错式的访问,会在事务里嵌套小事务,失败就回溯重试,还会实时检索散落的多模态数据,多步推理带来不可预测的并发,过去清晰的冷热表边界彻底被打乱。
很明显,人对世界有预设认知,Agent没有。如果数据库还停留在传统业务设计逻辑里,不去适配Agent的访问特性,未来AI跑得越快,数据库就越容易成为拖后腿的短板。这也是阿里云瑶池数据库团队,要给自己定“2个50%”阶段性目标的根本原因:一个50%,是指在数据服务方面,50%访问数据库的流量,由Agent驱动产生; 另一个50%,是在数据管理方面,50%的数据库实例由Agent创建与维护。
3大不可预测性,倒逼数据库重构
那么问题来了,Agent到底怎么用数据库?和人到底有什么不同?
“如果你的用户都变了,数据库仅仅为传统的业务模式去访问、去设计,这肯定不够。”陈分析了三大不可预测性。
首先,数据类型不可预测。 一次推理可能同时碰到结构化表、向量召回、JSON文档、关系图和全文检索。以前这种多模访问,一般会提前把多模内容检索出来放在文本里。但现在这些东西散落在各处,Agent不会做提前的数据预处理,都是实时访问。
其次,访问量不可预测。多步推理瞬间把并发拉满,闲时静默,忙时几十倍尖峰。一个Agent有多步推理的过程,同一个类型的Agent又会布很多个。
其三,访问模式不可预测。 探索式查询,先看表结构,再找数据。以前,有些表是热表、有些表是冷表,因为人类用户提前有基本的认知和判断。但Agent是探索式访问,会实际查看里面的内容是不是它要访问的内容,再做决定。
这也解释了陈宗志多次强调的一个观点:Agent-Native数据库不是简单的功能叠加,而是一次架构上的彻底重构。
模型会不会“吞掉”数据库?
业内有一种声音,当模型越来越强,数据库的访问方式发生根本变化,数据库会不会退回到存储层?我们可以看到,大模型厂商都开始往下“卷”,OpenAI做Memory,Anthropic做MCP生态,上下文窗口越拉越长。
“大模型做Memory和我们做Agent Context并不冲突,是互补关系。”陈宗志强调。
数据库这一层为什么不会被模型“吞掉”?有3个理由:
第一,成本。 百万Token窗口的推理费用远远高于数据检索。不可能每次的访问内容都需要通过大模型,如果内部检索有了结果,就可以通过内部检索来获得。
第二,企业级数据治理需要。 数据治理需要持久化、权限隔离、审计追溯——这些模型层做不了。
第三,多Agent协同。 大模型做的更多是针对单个Agent、单个会话的记忆。数据库厂商做的是提取、整理知识,不同场景需要用到不同记忆。这些Agent记忆应该成为公司最重要的知识财富,不应把这些核心知识留给大模型厂商,而应该作为自己的核心资产进行保留。
阿里云数据库推出Agent Context的目的,正是为了让企业能以更低的成本、更高的安全性进行内部知识检索与管理。大模型每次调用的成本远高于本地检索,通过数据库沉淀知识,能让整个团队以及跨Agent协同更高效。
“按调用计费”商业模式已快速普及
随着Agent的普及,数据库的商业模式也在经历深刻变革。
“技术、信任与商业模式是推动Agent渗透率从10%向50%迈进的三大要素,其中企业信任是当前的最大瓶颈”。陈宗志坦言,要完成两个50%目标,除了技术上的突破,还要跨越“信任”和“商业模式”上的门槛。
为了解决信任问题,阿里云数据库提供了沙箱、分支管理(Fork、Merge)等能力,让Agent在探索式访问中能够随时回滚,并提供全链路审计,确保Agent在探索式访问中能够随时回滚。
而在商业模式上,阿里云数据库已在头部模型公司有落地案例:亿级Sandbox、Scale-to-Zero成本降 70%。但这背后有个行业悖论——Agent 把调用量推高 10 倍,客户却期待账单更便宜。传统数据库不管有没有波峰波谷的流量,都收取固定费用。云原生数据库的Serverless模式支持按需弹性、按流量付费,而Agent时代更是把这一波浪潮推到了极致。
头部模型公司会瞬时创建亿级别Sandbox,单次调用量极大。虽然存活时间不长,但同时存活的亿级别生命周期,也将产生非常可观的费用。
陈宗志认为:面向未来,谁能把弹性做到极致,谁就能赢得市场。以阿里云头部C端应用“秒悟”为例,该平台支持“一句话生成企业级生产应用”。过去一年,受此类AI Agent场景驱动,RDS PostgreSQL实例的调用量激增了5倍。
无论是Vibe Coding还是AI Agent创建应用,今年虽只是起步,但未来的爆发式增长趋势已十分明确。
向Agentic DB形态加速进化
如今,阿里云瑶池数据库正在向Agentic DB形态加速进化,包括PolarDB、RDS、AnalyticDB、Lindorm、Tair等一系列云数据库,都在围绕Agent进行重构,核心目标是打造新一代Agent友好型数据库。
“Agentic DB不是一款全新的数据库产品,而是所有数据库在 Agent 时代必须具备的能力增强。”陈宗志认为,从AI Ready到AI Native,再到如今的Agentic-Native,虽然概念层出不穷,但终极方向一致,那就是成为用户友好的数据库。
大体来看,Agentic DB有4大关键特征:
1.多模数据处理。一个引擎支撑文本、向量、图等多种模态,避免数据孤岛。
2.极致Serverless弹性。支持秒级冷启动与Scale to Zero,适应短生命周期任务。
3.数据库分支能力。像Git管理代码一样管理数据,支持零拷贝的Fork与Merge,适应Agent的探索式工作流。
4.自然语言接口。支持MCP等协议,让Agent能通过自然语言直接操作数据库。
为了推动Agent加快落地,阿里云还发布了AI原生数据库服务(简称AIDBS)。AIDBS是企业级Data-Centric Agent 的一站式开发与服务平台,让数据能够被 Agent 理解、编排、流动与监管。
问题是,在过去一年里,几乎所有的数据库厂商都在围绕Agent重构数据底座,到底谁才是标准?
“谁对Agent更友好,谁能满足Agent的需求,谁就是这个时代的标准。”陈宗志的回答很干脆。他认为Agentic-Native数据库没有统一标准,阿里云瑶池不会给出一个终极答案,而是让Agentic-Native变成一个可讨论、可验证、可迭代的系统工程。
写在最后
从技术变革的终极方向来看,AI正在重构一切。数据库也在从存放数据的仓库,进化为主动赋能Agent的智能中枢。而在这场变革中,真正的定义权,属于那些能够让Agent真正跑起来、成为Agent运行原生底座的产品。

